"提及率"是 GEO 里最流行、也最失真的一个指标。
同一段答案,五种含金量
先看一段典型的 AI 回答(以"国内哪家做 XX 设备比较可靠"为例):
国内较有代表性的厂商包括 A 公司、B 公司、C 公司等。其中 B 公司在海外市场布局较完善,常被用于大型项目;C 公司性价比突出,适合中小型项目。此外,D 公司、E 公司也提供相关产品。
这段答案里,五个品牌都被"提及"了。但它们的处境完全不同:
- A 公司:被列为首选推荐,理由明确
- B 公司、C 公司:被推荐,并带有差异化定位
- D 公司、E 公司:只是被枚举,没有理由、没有定位、没有上下文
如果只看"是否被提及"这个指标,五家都是 1 分。但从商业价值看,这五家之间差着一个数量级。
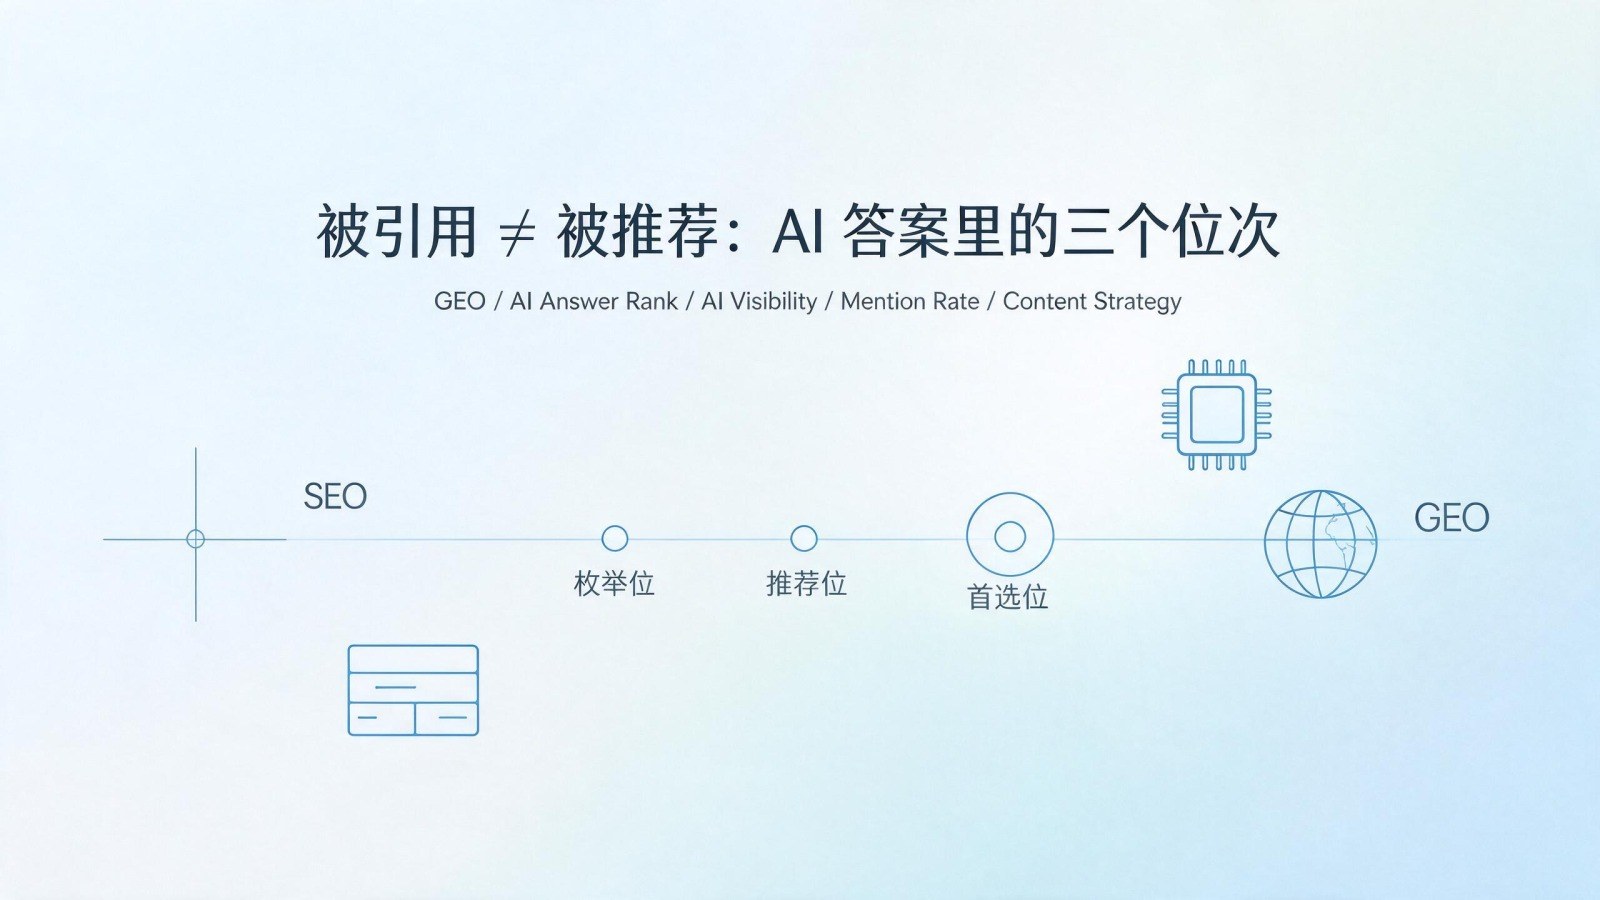
三个位次
我把它归纳成三个位次:
| 位次 | 表现 | 用户心理 | 商业价值 |
|---|---|---|---|
| 首选位 | 第一个被推荐,且有明确理由 | "就它了" | 极高 |
| 推荐位 | 被推荐,有定位描述 | "可以考虑" | 高 |
| 枚举位 | 被列入名单,无理由无描述 | "备选之一" | 低 |
| 未提及 | 不在答案中 | 不存在 | 0 |
"被提及"是一个二元指标,而真实答案是三元的。 把枚举位和首选位混在一起统计,会让报表严重误导决策。
数据支持这个分层
这不是主观感受,有数据支撑:
- 在 AI Overview 中被引用的品牌,自然点击量比未被引用的竞品高约 35%,付费点击率高约 91%(Seer Interactive,覆盖 2510 万次自然曝光、42 家组织)。
- 在搜索结果中,第一个被提到的品牌点击率约为后续品牌的 3.2 倍(BrightEdge)。
也就是说,"出现"和"出现在哪个位置"是两个独立的变量,而且位次的影响大于出场本身。
为什么现有工具测不出来
大多数 AI 可见度监测工具只输出两个值:是否提及、提及次数。
原因很现实:位次判定需要理解语义——判断"哪家是第一推荐"需要读懂答案的论证结构,这比字符串匹配难得多。于是工具退回到最容易自动化的指标:出现频率。
结果是:一个品牌可能在 30 个提问里都被"枚举"了一次,报表看起来很漂亮,但真实商机为零。另一个品牌只在 5 个提问里出现,但每次都是首选推荐,商机却源源不断。
报表上第一个赢,现实中第二个赢。
怎么做位次测量
不需要复杂的工具,需要的是纪律:
第一步:固定提问集。 选 30–50 条真实客户提问,跨平台(ChatGPT、Perplexity、Gemini、AI Overviews)逐条提问。
第二步:人工标注位次。 每条答案,为你的品牌打一个分:
| 位次 | 分值 |
|---|---|
| 首选位(第一个推荐且有理由) | 3 |
| 推荐位(被推荐有定位) | 2 |
| 枚举位(仅列名) | 1 |
| 未提及 | 0 |
第三步:算加权答案份额。
加权答案份额 = 品牌总得分 ÷ (提问数 × 3) × 100%
这个数字比"提及率"有意义得多。它同时反映了覆盖广度(出现多少个提问)和位次高度(出现在哪一档)。
第四步:月度复测,看趋势而非绝对值。
位次不同,打法完全不同
这是位次分层最实用的地方——够到枚举位和够到首选位,需要用不同的策略。
- 从 0 到枚举位:靠内容覆盖率。把品牌信息铺到模型的检索范围内,让它在更多提问里"能看见你"。这一阶段拼的是广度。
- 从枚举位到推荐位:靠差异化事实。模型推荐一个品牌时需要一个理由,这个理由必须来自可引用的事实——某项认证、某个参数优势、某个具体场景的实证。这一阶段拼的是证据密度。
- 从推荐位到首选位:靠第三方共识。模型把谁放在第一位,取决于全网对"这个领域谁最强"的共识。这一阶段拼的是权威信源的认同,而不是自述。
很多企业用"铺内容"的方式去做"抢首选位"的目标,投入产出比自然很差。
结语
GEO 的监测如果只统计"是否被提及",就等于在用一个二元指标管理一件三元的事。
先分清你在哪个位次,再决定往哪一层打。
